AI 这周答得挺好,下周同一个问题答歪了。你以为是它抽风,其实是你从来没测过它。
说个最常见的。上周给客户演示,AI 把两档价格算得清清楚楚,一屋子人鼓掌。这周真用起来,同一个问题,它把两档加在一起报了。业务当场脸就白了。事后复盘,谁也说不出为什么——因为从上线到现在,没人拿同一批问题反复问过它。
模型不是程序,同样的输入不保证同样的输出。这不是缺陷,是它的工作方式。既然稳定不能靠保证,就只能靠一件事兜住:每次改动前后,拿一批固定的问题跑一遍,把结果摆出来比。
没测过的 AI,不叫上线,叫试运气。
这篇讲测试集这个岗位:三类样本怎么编、五步怎么跑,以及哪三句话它不该下结论。
01 · THE JOB
它不评价 AI 聪不聪明,只回答「这次改动有没有把原来对的弄坏」
边界先说清楚。它不做模型选型、不调参数、不定业务规则。它只做一件事:维护一批固定的问题样本,每次改动前后各跑一遍,把两次结果摆在一起,标出哪些原来对、现在错。
测试集的价值不在证明它行,在证明它没变差。
唯一结果:任何一次提示词改动、知识库更新、模型换版本,都能在半小时内知道「哪些原来答对的,现在答错了」。注意是半小时内——超过一天才发现,业务已经拿错答案干活了。
为什么不能靠人工抽检?因为人抽检永远抽自己关心的那几条,而坏掉的往往是你不关心的那几条。固定样本的作用,就是替你记住那些你早就忘了的坑。
02 · INPUTS
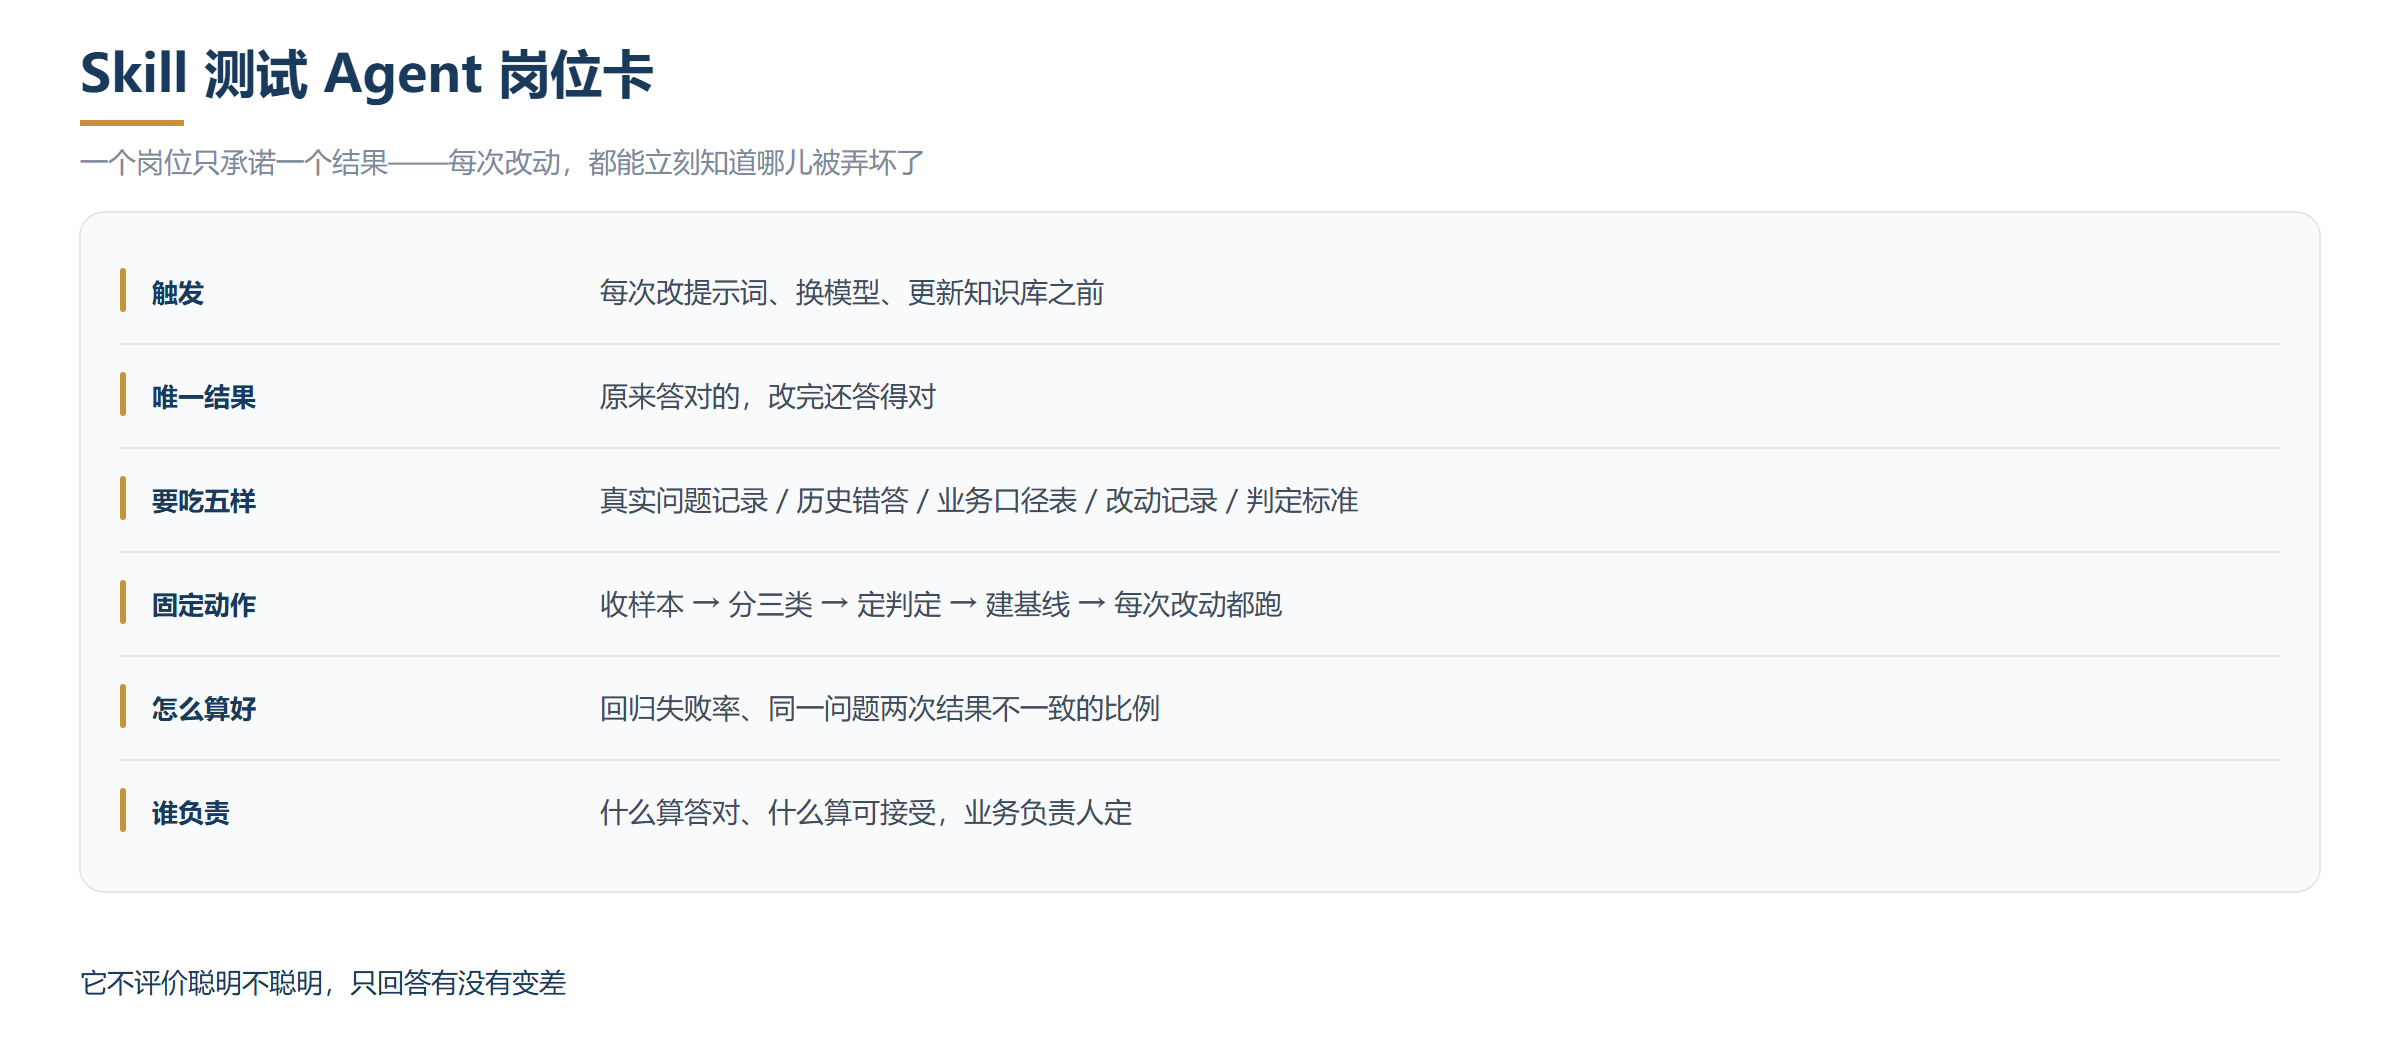
喂它五样,最要紧的是「业务的原话」,不是改写过的题
五类材料。第一样最要紧,也最容易被搞坏。
| 要喂什么 | 具体指什么 | 没喂会怎样 |
|---|---|---|
| 真实问题记录 | 业务真正问过的原话,错别字和口语都留着 | 测的是你编的题,不是它要面对的世界 |
| 历史错答 | 曾经答错、被谁纠正过、错在哪 | 老坑重犯,还得再被客户指一次 |
| 业务口径表 | 标准答案的依据,报价、交期、服务范围 | 判对判错没有标尺,只能凭感觉 |
| 改动记录 | 提示词、知识库、模型版本每次变化 | 跑出差异也归不了因 |
| 判定标准 | 什么算对、什么算可接受、什么算错 | 每次都吵,吵完还没结论 |
第一样最容易走形。很多人编测试题时,会不自觉地「把问题写清楚」——补上背景、补全条件、把口语改成书面语。可真实用户从来不好好说话。样本必须是原话,省略的主语、打错的字、前后矛盾的描述,全都留着,那才是它每天要处理的输入。
第四样决定这套东西有没有用。没有改动记录,跑出来的差异就归不了因:不知道是哪次改动引起的,只能干瞪眼,最后不了了之。
硬纪律:样本只增不删。觉得某条过时了,标「暂停」并写明原因,不许直接删——三个月后你会想把它找回来。
03 · PROCESS
五步走,第三步的尺度必须提前定
五步:收样本、分三类、定判定、建基线、每次改动都跑。
第一步收样本。从客服记录、销售群、客服电话里捞真实的提问,一次捞五十条左右就够起步。不要坐在办公室里编,编出来的题一定比真实问题干净,也一定测不出问题。
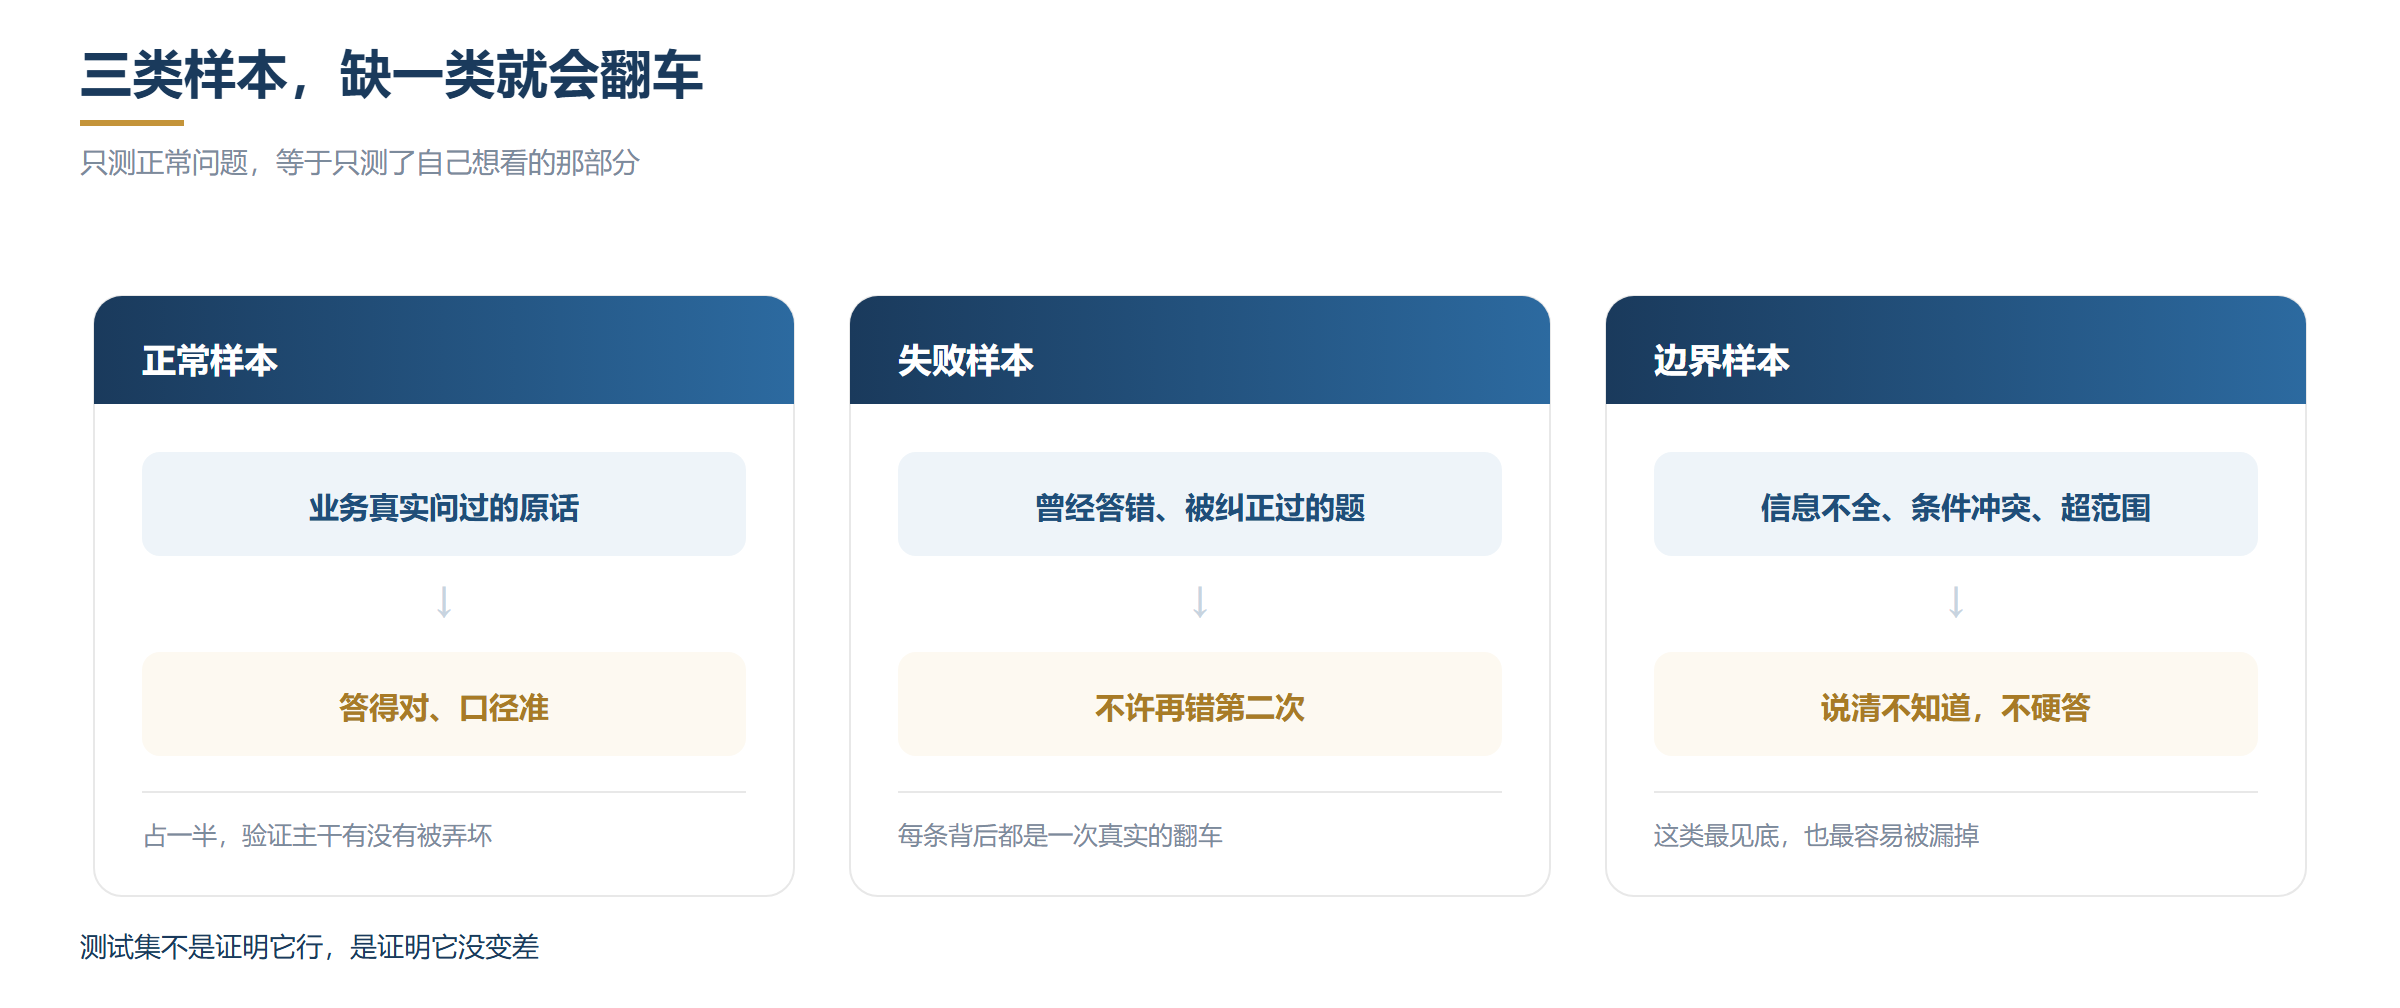
第二步分三类:正常样本、失败样本、边界样本。正常样本占一半,验证主干没坏;失败样本是历史错答,验证老坑没重犯;边界样本是那些说不清的问题——信息不全、条件互相冲突、压根超出它的职责范围。
第三步定判定,这一步最容易被草率带过。每条样本必须写清「什么算过」。判「对」容易,判「可接受」最难:答了但多说了两句不相关的,算过还是不过?这个尺度必须提前定死,事后定一定吵,而且吵不出结果。
第四步建基线。第一次跑的结果整份存下来,作为基准版本,连日期一起记。以后每次改动,都跟这份基准逐条比,不看绝对值,只看变化。
第五步每次改动都跑,包括你以为「只是改了个字」的那种。提示词最容易在改一个字之后整段变味:语气变了、结构变了、原来会追问一句现在不追问了。这种变化肉眼看不出来,只有样本能抓。
04 · PROMPT
可以直接抄的提示词
这段直接复制去用。留意第五条——不许自己改样本。它一定会「顺手」把表述不清的题改通顺,改完你就再也测不出真实输入下的问题了。
PROMPT · 可直接复制
角色:Skill 测试岗 唯一业务结果:每次改动前后,说清哪些原来对的现在错了 触发条件:改提示词、换模型、更新知识库之前 可用输入:真实问题记录、历史错答、业务口径表、改动记录、判定标准 执行链:收样本 → 分三类 → 定判定 → 建基线 → 每次改动都跑 工作纪律: 1. 先说明本次改动改了什么、影响哪类问题; 2. 样本必须原样使用,不许改写、不许补全条件; 3. 每条判定必须写依据,依据只能来自业务口径表; 4. 结果分三档:通过、可接受、不通过,并说明理由; 5. 不许增删样本,认为需要调整的单独列一节说明; 6. 两次结果不一致的,标为不稳定,单独统计; 7. 涉及业务规则对错的判定,停止并交业务负责人。 请输出:改动说明 → 样本清单 → 逐条结果 → 与基准的差异 → 不稳定项 → 建议。 本次材料:〔真实问题记录、历史错答、业务口径表、改动记录、判定标准〕
05 · CHECKLIST
第一轮跑完,先看这五样在不在
✓ 样本来自真实提问的原话,没有被改写成书面语
✓ 三类样本齐全,边界样本不少于十条
✓ 每条都写了判定依据,依据能指回业务口径表
✓ 有基线版本,且标了日期和当时的模型版本
✓ 结果里单独列出了「两次跑不一致」的那几条
最后一条常被忽略,但它比失败项更值得看:同一个问题两次答得不一样,说明这块它本来就没把握。
06 · BOUNDARY
三句话,它不该下结论
它能跑测试、能比差异,但下面三句话得由人来判断。
| 控制项 | 最低要求 | 不达标怎么办 |
|---|---|---|
| 开始时 | 样本与口径表齐 | 退回,并列出缺哪一类 |
| 执行中 | 每条结果能指回样本和依据 | 标为待核,不写成结论 |
| 上线前 | 回归失败率、不稳定项都有数 | 不达标不许上,回到改提示词 |
| 碰到规则 | 业务规则对错由业务负责人定 | 停止输出,交回给人 |
第一句:「这次改动是安全的。」安全不安全看跑测结果,不看改动大小。改一个标点也可能让整段输出换语气,这种事发生过太多次,凭感觉判断迟早出事。
第二句:「它答不好,是模型不行。」先看样本是不是超范围。很多「不行」,是把不该它回答的事塞给了它——问的是权限外的事、问的是没写进任何文档的口径,它答错才是正常的。
第三句:「这批样本够用了。」样本要跟着业务变。口径改了、产品改了、客户常问的问题改了,样本不跟着改,测出来的「通过」就是假的——它通过的是一套已经过时的标准。
说到底,AI 的稳定不是调出来的,是测出来的。你不可能让它每次都答得一样,但你可以做到每次它变了,你第一时间就知道。它负责告诉你哪里坏了,你负责决定这个坏能不能接受。
这套岗位卡的写法,我们是按「诊断—选岗—试运行—验收」四步落地的。
从最小的一步开始:把最近一个月业务问过的问题,原话抄下来,凑三十条,连同当时的正确答案存成一张表。下次你要改提示词,先拿这三十条跑一遍,记下结果,改完再跑一遍。两次一比,你就知道这次改动到底动了什么。
挑一场,补上今年最缺的那块 —— 长三角开班,可预约试听
国际市场开拓与商务实战
11月10日 · 职场素养 · 上海 | ¥5000/人
应用AI快速解决复杂品质问题
11月10日 · 数字化 · 嘉兴 | ¥4800/人
金牌班组长全技能提升
11月10日 · 管理技能 · 苏州 | ¥4000/人
高屋建瓴和脚踏实地:AI落地的自上而下和自下而上
11月10日 · 数字化 · 上海 | ¥4800/人
WOW!客户服务与投诉应对技巧
11月11日 · 职场素养 · 上海 | ¥4800/人
ISO 9001 质量管理体系标准理解、实施及内审员培训
11月11日 · 质量体系 · 上海 | ¥2000/人
完整排期与课纲,见 课程中心 →|咨询:15851577470 李老师